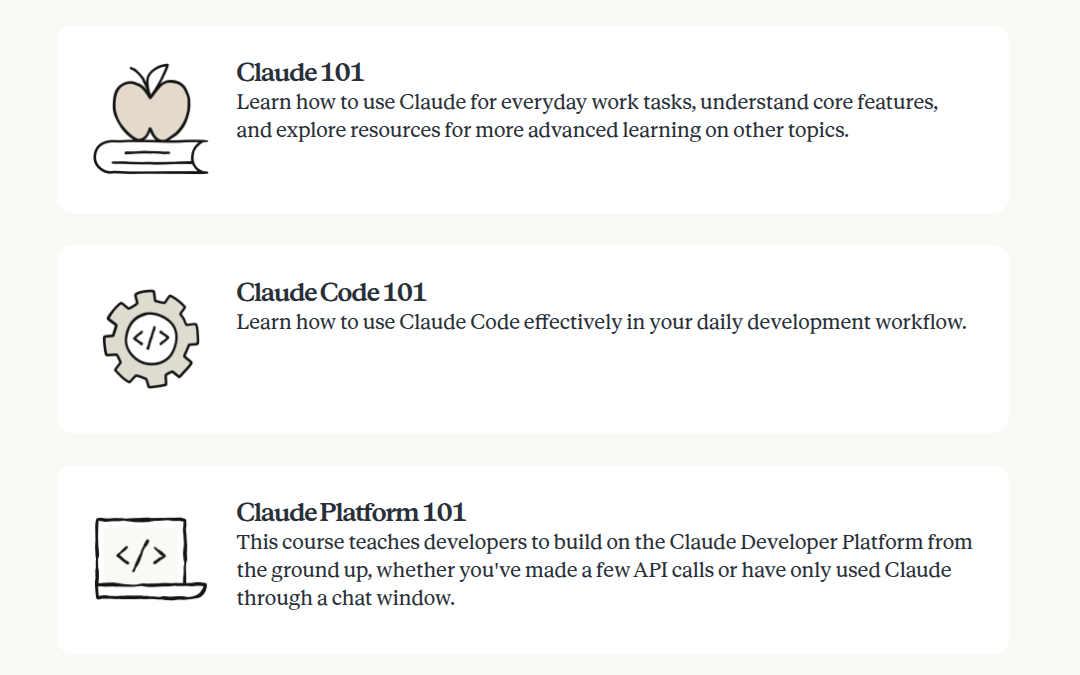
Platforma Anthropic Academy udostępnia 17 darmowych szkoleń technicznych i biznesowych, standaryzując procesy implementacji modeli z rodziny Claude. Selekcja odpowiednich ścieżek edukacyjnych pozwala organizacjom zredukować czas onboardingu inżynierów oraz zminimalizować ryzyka operacyjne wynikające z błędnej konfiguracji narzędzi sztucznej inteligencji.
Jakie kompetencje weryfikuje i standaryzuje Anthropic Academy?
Platforma edukacyjna Anthropic Academy, udostępniona w marcu 2026 roku, opiera się na infrastrukturze Skilljar i oferuje 17 bezpłatnych modułów szkoleniowych. System certyfikuje kompetencje na trzech poziomach, wymagając autoryzacji wyłącznie poprzez adres e-mail, co eliminuje wymóg posiadania bezpośredniego konta w środowisku Anthropic.
Systematyzacja wiedzy opiera się na podziale ról w organizacji, co pozwala zautomatyzować wewnętrzne ścieżki szkoleniowe. Zamiast obciążać wszystkich pracowników pełnym zakresem materiału, proces zdobywania kompetencji należy optymalizować poprzez kategoryzację:
- Użytkownicy biznesowi i nowi pracownicy: Moduły „Claude 101” i „Introduction to Claude Cowork” skracają czas wdrożenia do 60 minut. Funkcja Cowork pozwala modelowi na bezpośredni dostęp do lokalnych folderów i generowanie plików (np. Word, Excel, PDF), realizując procesy poprzez cykl: Planowanie, Egzekucja, Sterowanie (korekta kierunku) i Weryfikacja.
- Zarządzanie i edukacja: Szkolenia z serii AI Fluency, stworzone z badaczami akademickimi, wdrażają framework 4D: Delegowanie (Delegation), Opisywanie (Description), Ocenianie (Discernment) i Rzetelność (Diligence). Pozwala to zoptymalizować pętlę sprzężenia zwrotnego pomiędzy formułowaniem instrukcji a weryfikacją wyników, minimalizując błędy poznawcze operatorów.
- Inżynierowie i programiści: Dedykowane minimum 5 kursów technicznych obejmujących Claude Code, operacje na API oraz standard Model Context Protocol (MCP).
Podatności i ryzyka: Funkcja Cowork oraz bezpośredni dostęp do plików lokalnych wymagają ścisłego zarządzania uprawnieniami na poziomie systemu operacyjnego, aby zapobiec nieautoryzowanemu odczytowi lub modyfikacji krytycznych dokumentów organizacji przez procesy agentowe.
Jak zarządzać kontekstem i integracjami z użyciem Claude Code?
Środowisko Claude Code stanowi agenta uruchamianego bezpośrednio w terminalu, co wymaga od operatorów znajomości powłoki systemowej i systemu kontroli wersji Git. Architektura integruje się z lokalnymi repozytoriami, umożliwiając automatyzację cyklu operacyjnego od analizy struktury do zatwierdzania zmian, bazując na konfiguracji z pliku CLAUDE.md.
Wdrażanie Claude Code pozwala zoptymalizować powtarzalne procesy programistyczne poprzez:
- Niestandardowe komendy (Slash commands): Automatyzacja rutynowych zadań w katalogu
.claude/commands/. - Mechanizmy Hooks: Wymuszanie deterministycznych zachowań modelu (np. PreToolUse, PostToolUse, Stop) narzucających reguły formatowania i walidacji kodu.
- Agent Skills (SKILL.md): Tworzenie ustandaryzowanych instrukcji w oparciu o technikę Progressive Disclosure. Pozwala to odciążyć okno kontekstowe poprzez przeniesienie szczegółów do katalogów referencyjnych i szablonów.
Podatności i ryzyka na poziomie architektury agentów: Tworzenie sub-agentów (niezależnych procesów wywoływanych poleceniem /agents) generuje zagrożenia związane z niekontrolowanym zużyciem zasobów i wyciekiem danych. Należy tu bezwzględnie stosować zasadę najmniejszego uprzywilejowania (Least Privilege), ograniczając sub-agentom dostęp wyłącznie do niezbędnych narzędzi. Konieczne jest też wdrożenie formatów ustrukturyzowanych wyjść (Structured output) oraz ścisłego raportowania błędów (Blockers).
Architektura integracji API i wyzwania infrastrukturalne w chmurach AWS i GCP
Implementacje produkcyjne oparte na Anthropic API, Amazon Bedrock oraz usłudze Google Cloud Vertex AI wymuszają integrację z natywnymi mechanizmami zarządzania uprawnieniami. Szkolenia techniczne szczegółowo omawiają architekturę systemów RAG, przetwarzanie wieloetapowe oraz mechanizmy optymalizacji kosztów infrastruktury, w tym funkcje Extended Thinking i Prompt Caching.
Zależnie od wybranego dostawcy chmurowego, procesy integracji należy optymalizować na poziomie samej infrastruktury:
- Amazon Bedrock: Korzystanie z ujednoliconego interfejsu Converse API minimalizuje koszty refaktoryzacji kodu przy zmianie modeli. Zapewnia natywną obsługę prywatnej komunikacji przez VPC, co eliminuje ekspozycję zapytań na publiczny internet.
- Google Cloud Vertex AI: Środowisko to oferuje bezpośrednią integrację z hurtownią danych BigQuery. Użycie funkcji
ML.GENERATE_TEXTw zapytaniach SQL drastycznie optymalizuje przetwarzanie dużych wolumenów danych, eliminując narzut na transport danych.
Podatności i ryzyka bezpieczeństwa: Podstawowym wektorem ataku przy wykorzystaniu API jest kradzież danych uwierzytelniających. W środowisku GCP należy unikać stosowania statycznych kluczy JSON dla kont usług, zastępując je mechanizmem Workload Identity przy integracji z Cloud Run lub GKE. W przypadku AWS konieczna jest integracja z IAM oraz wdrażanie Guardrails (filtrowania treści) w celu blokowania wstrzykiwania złośliwych promptów.
Wdrażanie Model Context Protocol (MCP) w środowiskach produkcyjnych
Model Context Protocol (MCP) to ustandaryzowany protokół łączący modele języka z infrastrukturą zewnętrzną. Wdrożenia produkcyjne, obejmujące serwery i klienty w języku Python, definiują architekturę w oparciu o narzędzia (Tools), zasoby (Resources) i szablony instrukcji (Prompts), wymagając rygorystycznej kontroli dostępu do systemów plików.
Dzięki wykorzystaniu pakietu Python SDK (FastMCP) można zoptymalizować proces deweloperski, transformując pojedyncze funkcje w pełnoprawne narzędzia (Tools) za pomocą jednego dekoratora i testując je w przeglądarce przy pomocy MCP Inspector. Wdrożenie na produkcję wymusza zdefiniowanie strategii transportowej: komunikacja lokalna (stdio) lub zdalna za pomocą Streamable HTTP. Architektura bezstanowa (Stateless HTTP) optymalizuje horyzontalne skalowanie usług.
Podatności i ryzyka systemowe: Rozszerzanie możliwości modelu poprzez serwery MCP tworzy krytyczne punkty styku. Przekazanie AI zdolności do odczytu danych konfiguracyjnych poprzez „Resources” grozi ujawnieniem sekretów aplikacji. Konieczne jest wdrożenie mechanizmów izolacji takich jak Roots-based file access control, definiujących ścisłe granice uprawnień modelu w systemie plików serwera. Niewłaściwa walidacja przy autoryzacji żądań typu „Sampling” (gdzie serwer prosi klienta o wywołanie LLM) może prowadzić do nieprzewidzianych obciążeń finansowych API.
Wnioski praktyczne i rekomendacje
- Skonfiguruj warstwy uprawnień systemu plików z wykorzystaniem Roots-based access control przed wdrożeniem serwerów Model Context Protocol (MCP) na środowisko produkcyjne.
- Wdróż środowisko AWS Bedrock we współpracy z mechanizmami VPC i Guardrails, by odseparować ruch sieciowy modelu LLM od publicznego internetu i blokować szkodliwe prompty.
- Zoptymalizuj przetwarzanie dużych zbiorów danych w środowiskach GCP, wykonując polecenie
ML.GENERATE_TEXTbezpośrednio na poziomie zapytań SQL w hurtowni BigQuery, eliminując koszty transferu danych. - Zmierz i zredukuj obciążenie okna kontekstowego w cyklach programistycznych poprzez podzielenie procedur w plikach SKILL.md (Progressive Disclosure) na powiązane skrypty i separację za pomocą sub-agentów z minimalnymi wymaganymi uprawnieniami (Least Privilege).


Dodaj komentarz